
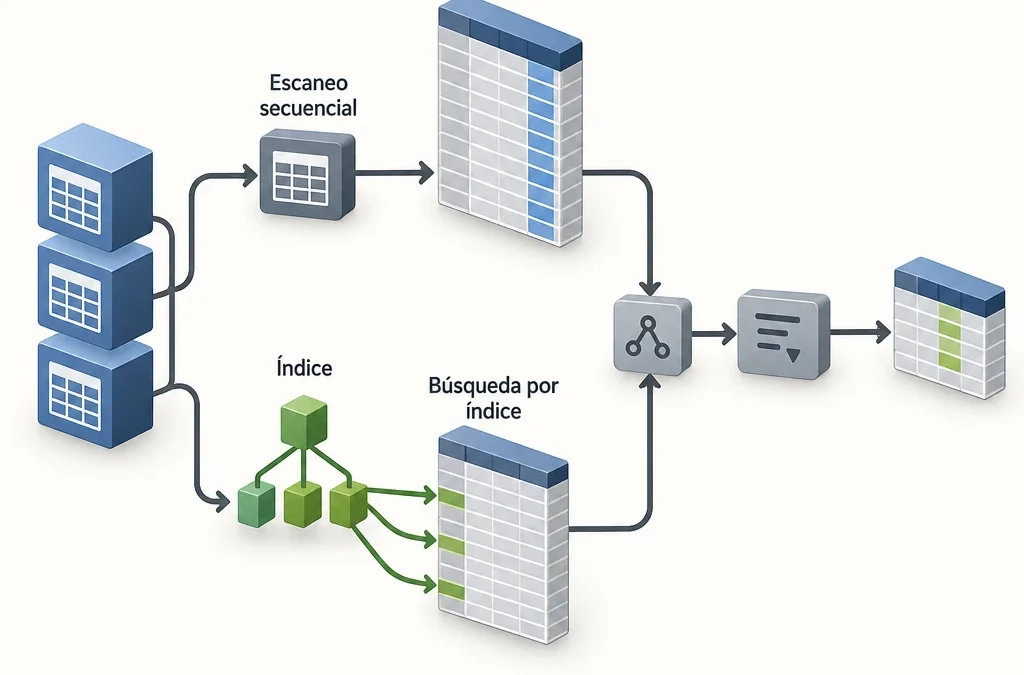
Cuando una vista de Odoo tarda ocho segundos en cargar o un informe bloquea al equipo de administración, la tentación es crear un índice y esperar. Para optimizar consultas en PostgreSQL con garantías necesitas seguir otro orden: localizar la consulta que más pesa en la carga real, leer su plan de ejecución, elegir el índice adecuado y medir el resultado antes y después.
Seguimos ese recorrido con una consulta típica de Odoo, desde su detección hasta la validación del índice. También vemos qué coste tiene ese índice en escrituras y mantenimiento, porque el objetivo es mejorar el rendimiento del conjunto de la actividad de la empresa, no conseguir un Index Scan a cualquier precio.
Puntos clave:
- Prioriza por tiempo total en pg_stat_statements, no por la consulta más lenta.
- El coste del plan se expresa en unidades arbitrarias, no en milisegundos.
- Un Seq Scan es adecuado para tablas pequeñas o lecturas masivas.
- EXPLAIN ANALYZE ejecuta la sentencia: protege los UPDATE y DELETE con una transacción.
- Cada índice nuevo encarece INSERT, UPDATE, DELETE y VACUUM.
- Valida con varias ejecuciones, la caché controlada y un volumen de datos real.
¿Qué consultas merece la pena optimizar primero?
Empieza por las consultas que acumulan más tiempo total de ejecución, no por la más lenta de forma aislada. Una consulta de 40 ms que se ejecuta 200.000 veces al día consume unos 8.000 segundos, mientras que un informe de 30 segundos lanzado dos veces suma solo 60. La extensión pg_stat_statements te da esa visión de conjunto.
Activar pg_stat_statements
La extensión forma parte de los módulos contrib de PostgreSQL y necesita cargarse al arrancar el servidor. En un despliegue con Docker, añade `shared_preload_libraries = 'pg_stat_statements'` al `postgresql.conf` montado en el contenedor, o pasa ese ajuste con `-c` en el comando del servicio. Después reinicia el contenedor y ejecuta `CREATE EXTENSION pg_stat_statements;` en la base de datos de Odoo.
Ten en cuenta que el cambio exige reiniciar PostgreSQL, así que conviene planificarlo fuera del horario laboral. La sobrecarga de la extensión es baja y queda compensada con creces por lo que permite descubrir.
Ordenar por impacto real
Para ver el peso de cada consulta en la carga, ordena por `total_exec_time` y no solo por `mean_exec_time`:
```sql
SELECT calls,
round(total_exec_time::numeric, 0) AS total_ms,
round(mean_exec_time::numeric, 1) AS media_ms,
rows,
shared_blks_hit, shared_blks_read,
left(query, 120) AS consulta
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;
```
La relación entre `shared_blks_hit` y `shared_blks_read` indica cuánto se sirve desde la caché de PostgreSQL y cuánto obliga a leer del disco o de la caché del sistema operativo. Una consulta con muchos bloques leídos y pocas filas devueltas es una candidata clara a beneficiarse de un índice.
Como ejemplo, imagina que aparece en primera posición la búsqueda que el ORM de Odoo lanza al abrir la lista de facturas de un cliente. Tarda una media de 180 ms y se ejecuta 45.000 veces al día, lo que suma unos 8.100 segundos diarios, más de dos horas de CPU. Esa es la consulta que seguiremos durante el resto del artículo.
¿Cómo genera el ORM de Odoo estas consultas?
El ORM traduce cada `search()`, `read_group()` o vista de lista en SQL con un patrón muy reconocible. Si sabes leerlo, sabrás qué índice falta sin tocar código Python. En nuestro ejemplo, `pg_stat_statements` muestra algo como esto, con los parámetros normalizados:
```sql
SELECT "account_move"."id" FROM "account_move"
WHERE ("account_move"."company_id" IN ($1))
AND ("account_move"."move_type" IN ($2, $3))
AND ("account_move"."state" = $4)
AND ("account_move"."partner_id" = $5)
ORDER BY "account_move"."invoice_date" DESC, "account_move"."id" DESC
LIMIT 80;
```
Hay varios rasgos típicos. El filtro por `company_id` aparece por las reglas multicompañía aunque solo tengas una empresa. El `ORDER BY` procede del `_order` del modelo o de la vista, y el `LIMIT 80` corresponde a la paginación por defecto de la vista de lista. Después, el ORM lanza una segunda consulta para leer los campos visibles de esos 80 identificadores.
Cada campo declarado con `index=True` en el modelo genera un índice B-tree de una sola columna. En `account_move`, `partner_id` y `state` suelen estar indexados por separado. El planificador puede usar uno, pero con índices independientes no resuelve bien el filtrado y la ordenación a la vez. Por eso aparecen planes que leen miles de filas para devolver 80.
Antes de cambiar nada, comprueba también si la lentitud procede de un campo calculado con `store=False` o de una regla de registro compleja. Ningún índice arregla una regla que genera subconsultas sobre `res_partner` en cada fila.
Cómo leer un plan de ejecución con EXPLAIN
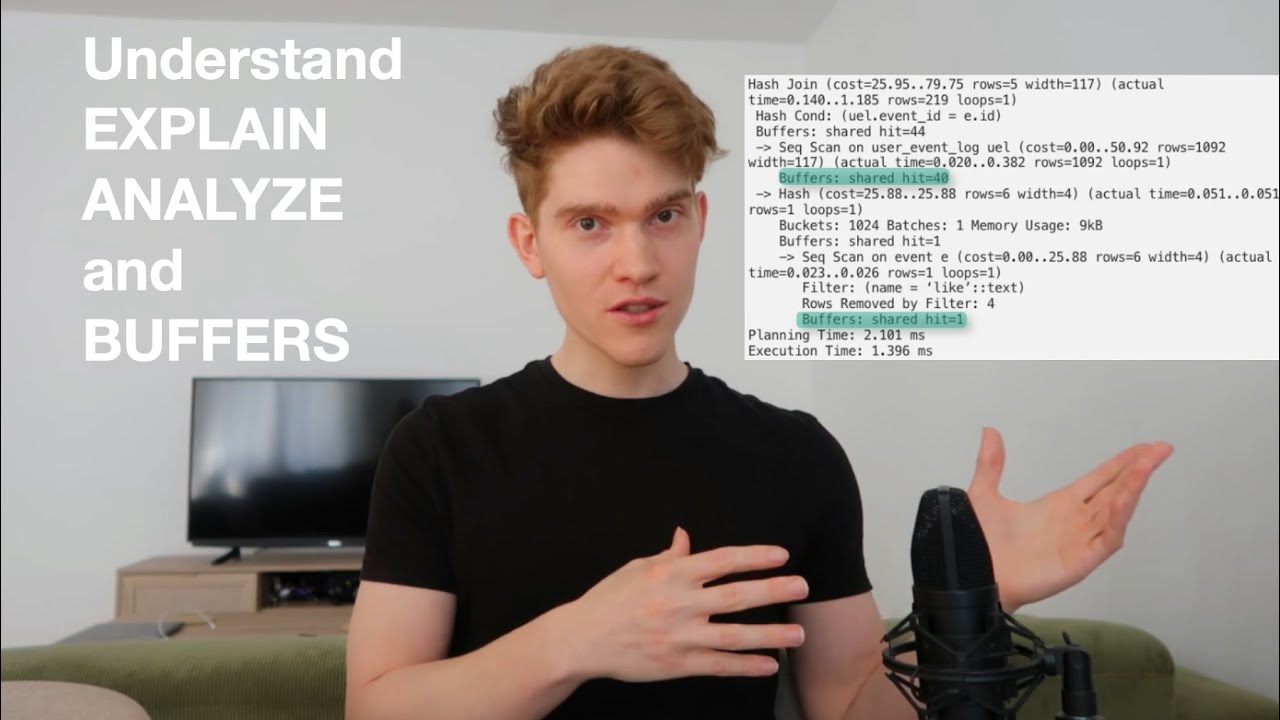

Un plan es un árbol de nodos: los hijos producen filas y los padres las consumen. Se lee de dentro hacia fuera. Para cada nodo, compara las filas estimadas con las reales y localiza dónde se concentra el tiempo y se lee el mayor número de bloques.
EXPLAIN frente a EXPLAIN (ANALYZE, BUFFERS)
`EXPLAIN` a secas muestra el plan estimado sin ejecutar nada. Se basa en las estadísticas de la tabla y es instantáneo, pero solo da previsiones. `EXPLAIN (ANALYZE, BUFFERS)` ejecuta la consulta de verdad y añade tiempos reales, filas reales por nodo y bloques leídos de la caché (`shared hit`) o fuera de ella (`read`).
Recuerda que ANALYZE ejecuta la sentencia. Un `EXPLAIN ANALYZE DELETE` borra filas y un `UPDATE` modifica datos y activa disparadores. Para analizar escrituras, inclúyelas siempre en una transacción como esta:
```sql
BEGIN;
EXPLAIN (ANALYZE, BUFFERS) UPDATE account_move SET . WHERE .;
ROLLBACK;
```
Incluso con ROLLBACK, la sentencia adquiere bloqueos mientras se ejecuta. Por eso, para analizar una sentencia de producción, conviene usar una copia restaurada a partir de la última copia de seguridad.
Coste, filas y bloques
Un nodo típico tiene este aspecto:
```
Index Scan using account_move_partner_id_index on account_move
(cost=0.43.9821.55 rows=310 width=8)
(actual time=0.05.171.20 rows=4120 loops=1)
Filter: (state = 'posted' AND move_type = ANY (.))
Rows Removed by Filter: 2950
Buffers: shared hit=1210 read=5340
```
El coste (`0.43.9821.55`) se expresa en unidades arbitrarias del planificador. Los dos valores indican el coste inicial y el total en términos relativos; no equivalen a milisegundos. Sirven para comparar planes alternativos de la misma consulta, no para predecir tiempos. El tiempo real está en `actual time`.
Fíjate en tres señales. La primera es que se estimaron 310 filas y salieron 4.120, más de 13 veces lo previsto, lo que suele indicar estadísticas poco precisas. La segunda es que `Rows Removed by Filter` muestra que el índice localiza filas que luego se descartan. La tercera es que los 5.340 bloques leídos fuera de la caché, a 8 kB por bloque, suman unos 42 MB de lectura para devolver 80 identificadores.
Encima de este nodo aparecerá un `Sort` sobre las 4.120 filas para aplicar el `ORDER BY invoice_date DESC` antes del `LIMIT`. Ahí está el cuello de botella completo: localizar demasiadas filas, filtrarlas y ordenarlas en memoria.
Para planes largos, exporta el plan con `FORMAT JSON` y pégalo en explain.dalibo.com, que dibuja el árbol y colorea los nodos más costosos. Si usas PostgreSQL 18, publicado el 25 de septiembre de 2025, EXPLAIN muestra además más detalles de entrada/salida, búsquedas en índices y actividad WAL por nodo, lo que agiliza este diagnóstico.
¿Un escaneo secuencial siempre es un problema?
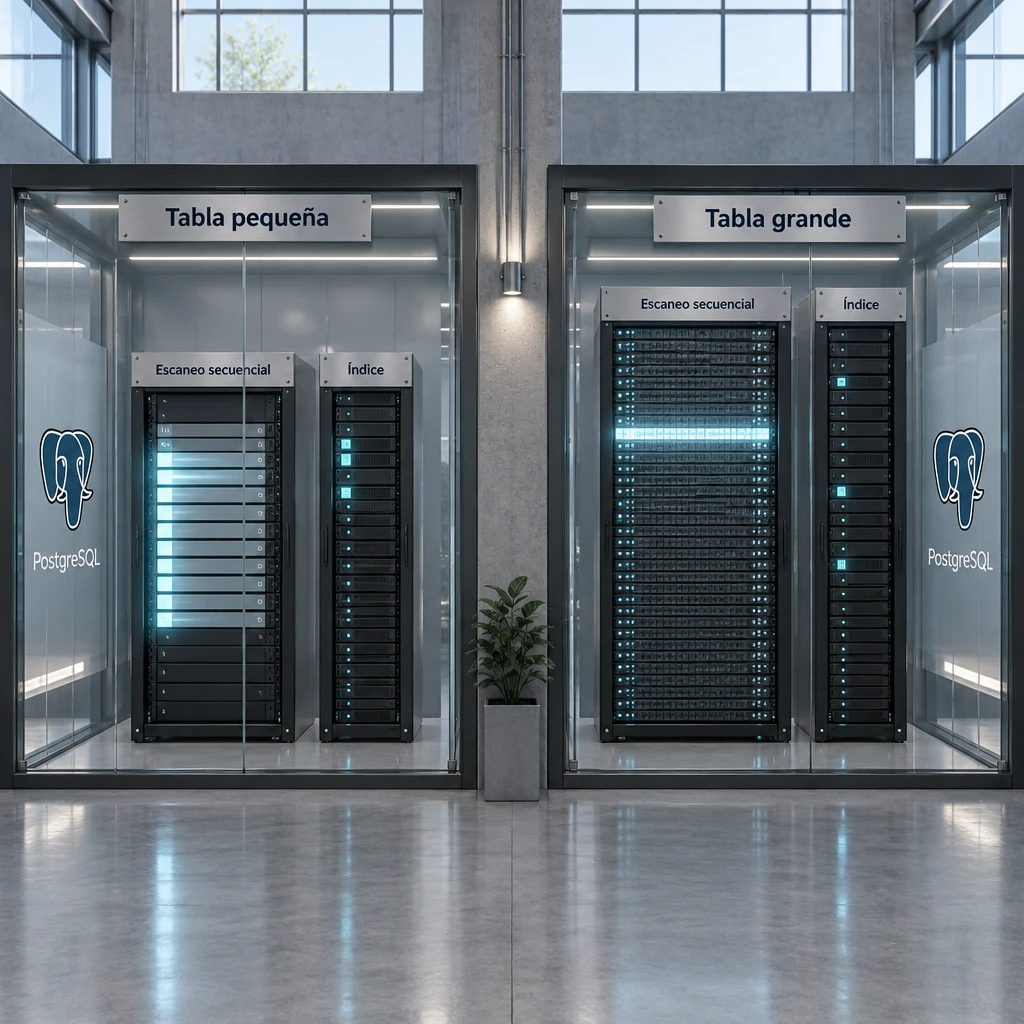
No. Un Seq Scan es la mejor opción cuando la tabla es pequeña o la consulta necesita una gran parte de sus filas. Leer páginas en orden es mucho más barato que saltar de forma aleatoria entre el índice y la tabla.
El planificador elige entre cuatro estrategias principales:
- Seq Scan: recorre toda la tabla. Es adecuado para tablas de pocos miles de filas como `res_company` o `account_journal`, y para informes que agregan casi todos los datos.
- Index Scan: recorre el índice y accede a la tabla (el heap) por cada fila encontrada. Es ideal para pocas filas o para devolverlas ya ordenadas.
- Bitmap Heap Scan: construye primero un mapa de las páginas que contienen filas válidas y luego las lee en orden físico. Encaja en un rango intermedio, de cientos a decenas de miles de filas, y puede combinar varios índices con `BitmapAnd`.
- Index Only Scan: responde solo con el índice, sin acceder a la tabla, siempre que el mapa de visibilidad esté al día. Es el más eficiente.
Un Seq Scan sí es señal de un problema cuando aparece sobre `account_move_line`, `stock_move` o `mail_message`, con millones de filas, para devolver unas pocas decenas. En ese caso, un valor de `Rows Removed by Filter` cercano al total de filas de la tabla lo delata.
Tampoco conviene forzar el uso de un índice con `SET enable_seqscan = off` salvo como experimento puntual en una sesión. Sirve para ver qué coste calcularía el planificador con el índice, pero nunca debe dejarse como ajuste permanente.
Por qué PostgreSQL ignora un índice que existe
El planificador ignora un índice cuando calcula que otra vía es más barata. Las causas habituales son unas estadísticas desactualizadas, una condición que no permite aprovechar el índice o una selectividad tan baja que leer la tabla entera sale más a cuenta.
Estadísticas, ANALYZE y autovacuum
Todas las estimaciones de filas proceden de las estadísticas que recoge `ANALYZE`: valores más frecuentes, histogramas y proporción de nulos por columna. Si tras una importación masiva o una migración de datos esas estadísticas siguen describiendo la tabla tal como era antes, el planificador elige mal. Ejecuta `ANALYZE account_move;` después de cualquier carga grande.
El autovacuum lanza ANALYZE de forma automática cuando cambia en torno al 10 % de las filas (`autovacuum_analyze_scale_factor = 0.1`) y VACUUM cuando cambia alrededor del 20 %. En tablas de 20 millones de filas, eso implica esperar 2 millones de cambios. Para las tablas grandes de Odoo, reduce esos umbrales en cada tabla:
```sql
ALTER TABLE account_move_line
SET (autovacuum_analyze_scale_factor = 0.02,
autovacuum_vacuum_scale_factor = 0.05);
```
VACUUM también importa para el plan. Mantiene el mapa de visibilidad que permite los Index Only Scan y retira las tuplas muertas, que inflan tablas e índices. Consulta `n_dead_tup` y `last_autoanalyze` en `pg_stat_user_tables` para comprobar si el mantenimiento llega a tiempo. Si una columna tiene una distribución muy desigual, como `state` con un 95 % de valores `posted`, aumenta el tamaño de la muestra con `ALTER TABLE . ALTER COLUMN state SET STATISTICS 1000;`.
Condiciones que no permiten aprovechar el índice
Un índice B-tree sobre `name` no sirve para `WHERE lower(name) = .`, ni para `ILIKE '%texto%'`, ni cuando hay una conversión implícita de tipo. Odoo genera muchas búsquedas `ilike` en los campos de nombre. Para esas búsquedas, el índice adecuado es GIN con `pg_trgm`, que Odoo crea para los campos declarados con `index='trigram'`.
En un índice compuesto, el orden de las columnas también cuenta. Un índice `(company_id, partner_id)` ayuda poco a una consulta que filtra solo por `partner_id`. PostgreSQL 18 añadió el skip scan en B-tree, que en algunos casos aprovecha índices sin usar su primera columna, pero solo resulta eficaz cuando esa columna tiene pocos valores distintos.
Cómo diseñar un índice B-tree, compuesto o parcial
Para nuestra consulta de facturas, la decisión correcta es un índice B-tree compuesto y parcial que cubra las condiciones de igualdad del filtro y el orden de los resultados. Así, PostgreSQL lee solo las primeras 80 entradas y no ordena nada en memoria.
El orden de las columnas en un índice compuesto
Coloca primero las columnas filtradas por igualdad, después las de rango y, al final, las del `ORDER BY` en la misma dirección. Entre las de igualdad, empieza por la que más uses sola en otras consultas, porque el índice sirve para cualquier prefijo de sus columnas. La documentación de PostgreSQL ilustra la idea con un índice `(major, minor)` para consultas que filtran por ambas.
Aplicado al ejemplo, `partner_id` va en cabeza (se filtra por igualdad y es muy selectiva), seguido de `invoice_date DESC` e `id DESC` para la ordenación:
```sql
CREATE INDEX CONCURRENTLY account_move_partner_invoice_idx
ON account_move (partner_id, invoice_date DESC, id DESC)
WHERE state = 'posted'
AND move_type IN ('out_invoice', 'out_refund');
```
`company_id` queda fuera porque, con una sola empresa, no filtra nada. Si trabajas en multicompañía con los datos realmente separados por empresa, añádelo justo después de `partner_id`.
Cuándo elegir un índice parcial
El índice parcial solo guarda las filas que cumplen su `WHERE`. Conviene cuando la consulta filtra siempre por el mismo valor y ese subconjunto representa una parte bien definida de la tabla. Si los borradores, asientos y facturas de proveedor suman el 60 % de `account_move`, el índice ocupa menos de la mitad. Además, las escrituras sobre esas filas excluidas no lo modifican.
El planificador solo lo usa si la consulta implica lógicamente su condición. Si el ORM envía `state = $4` como parámetro genérico, puede no reconocer esa implicación en los planes genéricos. Comprueba que el índice aparece en el plan final y usa `CONCURRENTLY` para no bloquear las escrituras mientras se construye.
El coste en escrituras y mantenimiento
Cada índice se actualiza con cada INSERT y DELETE, y con cada UPDATE que afecte a sus columnas o que no pueda resolverse como actualización HOT. En `account_move`, confirmar una factura cambia `state`, lo que obliga a insertar la entrada en el índice parcial. También aumenta el WAL generado, el tamaño de las copias de seguridad y el trabajo de VACUUM.
Un índice compuesto de tres columnas sobre 3 millones de filas puede ocupar del orden de 100 a 150 MB. Si lo añades sin retirar nada, la memoria compartida acaba repartida entre más estructuras. Revisa `pg_stat_user_indexes` y elimina los índices con `idx_scan = 0` tras semanas de actividad normal, salvo los que garantizan la unicidad.
Medir antes y después sin engañarte
Valida cada índice con una medición reproducible del conjunto de la carga, no con una ejecución suelta. La segunda ejecución de cualquier consulta suele ser más rápida porque los bloques ya están en caché. Si no lo tienes en cuenta, atribuirás al índice una mejora que no le corresponde.
Sigue este procedimiento:
- Restaura una copia reciente de producción en un entorno equivalente, con el mismo volumen de datos y la misma versión de PostgreSQL, y ejecuta `ANALYZE`.
- Ejecuta la consulta de cinco a diez veces con `EXPLAIN (ANALYZE, BUFFERS)`, usando parámetros reales: un cliente con 20 facturas y otro con 30.000. Anota la mediana y los bloques leídos, no el mejor tiempo.
- Mide también las escrituras afectadas, por ejemplo con `pgbench` y un script que inserte y confirme facturas, y registra las transacciones por segundo y el WAL generado.
- Crea el índice, repite los pasos 2 y 3 en las mismas condiciones y compara.
- En producción, ejecuta `SELECT pg_stat_statements_reset();` tras desplegar el índice y, al cabo de una semana, compara el `total_exec_time` de las consultas principales con el de la semana anterior.
En el ejemplo, el plan nuevo debería mostrar un Index Scan que se detiene al llegar a 80 filas, sin nodo Sort y con unas decenas de bloques leídos frente a los más de 6.500 anteriores. Si la mediana pasa de 180 ms a unos 2 ms, el tiempo de las 45.000 llamadas diarias baja de unos 8.100 segundos a 90.
Ese ahorro se contrasta con las mediciones del paso 3. Si la confirmación de facturas pierde un 2 % de rendimiento, el balance es claramente positivo. Si una importación nocturna de 500.000 líneas se alarga una hora, quizá convenga desactivar el proceso y reconstruir el índice después. La decisión se toma teniendo en cuenta toda la carga de trabajo de la empresa.
Por dónde empezar
Activa pg_stat_statements esta semana y deja que acumule siete días de actividad normal. Esa lista ordenada por tiempo total te permitirá identificar las tres o cuatro consultas que merece la pena optimizar y descartar el resto sin crear índices a ciegas. Si prefieres contar con soporte técnico para tu instalación de Odoo en Barcelona, Synergia lo ofrece con un SLA de respuesta de dos horas.
Preguntas frecuentes
¿Cuántos índices puede tener una tabla sin perjudicar el rendimiento?
No hay un número fijo. El límite lo marca la proporción entre lecturas y escrituras. En tablas con muchas escrituras, como `account_move_line` o `stock_move`, cada índice adicional se nota en las confirmaciones, así que justifica cada uno con una consulta concreta de pg_stat_statements.
¿Se puede crear un índice en producción sin parar Odoo?
Sí, con `CREATE INDEX CONCURRENTLY`, que no bloquea las escrituras. Tarda más y no puede ejecutarse dentro de una transacción. Si falla, deja un índice marcado como inválido que debes eliminar antes de reintentarlo.
¿Cada cuánto conviene ejecutar ANALYZE manualmente?
Normalmente basta con autovacuum, ajustado por tabla en las más grandes. Lanza `ANALYZE` a mano después de importaciones masivas, migraciones o borrados de gran volumen, porque, de lo contrario, el planificador trabajaría con estadísticas que describen una tabla distinta.
¿Sirve de algo aumentar work_mem para acelerar consultas?
Ayuda cuando el plan muestra ordenaciones u operaciones hash que desbordan la memoria y pasan a disco (`Sort Method: external merge`). Súbelo con prudencia: se reserva por operación y por conexión, y con muchos procesos de trabajo de Odoo puede agotar la memoria del servidor.