
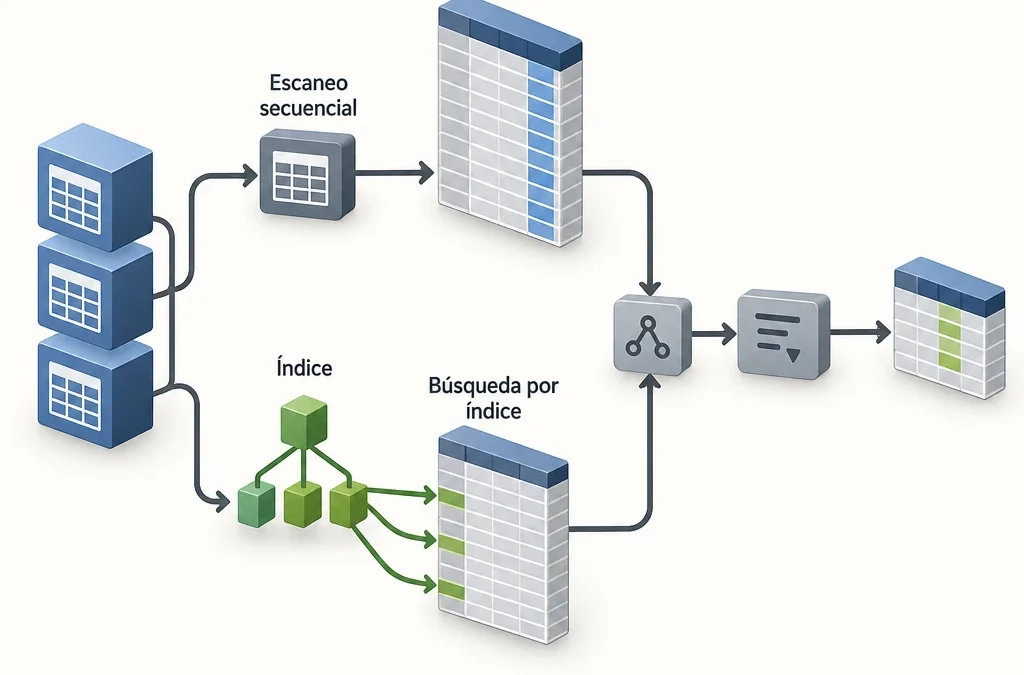
Quan una vista d'Odoo triga vuit segons a carregar-se o un informe bloqueja l'equip d'administració, és temptador crear un índex i esperar. Per optimitzar de manera efectiva les consultes de PostgreSQL, cal seguir un enfocament diferent: identificar la consulta que té el major impacte en la càrrega real, examinar el seu pla d'execució, triar l'índex adequat i mesurar els resultats abans i després.
Continuem aquesta visió general amb una consulta típica d'Odoo, des de la seva detecció fins a la validació de l'índex. També analitzem el cost d'aquest índex en termes d'operacions d'escriptura i de manteniment, perquè l'objectiu és millorar el rendiment global de l'empresa, no aconseguir una exploració d'índex a qualsevol preu.
Punts clau:
- Prioritzeu pel temps total a pg_stat_statements, no pas per la consulta més lenta.
- El cost del pla s'expressa en unitats arbitràries, no en mil·lisegons.
- Una Seq Scan és adequada per a taules petites o lectures massives.
- EXPLAIN ANALYZE executa la sentència: protegeix les sentències UPDATE i DELETE amb una transacció.
- Cada nou índex fa que les operacions INSERT, UPDATE, DELETE i VACUUM siguin més costoses.
- Valida mitjançant múltiples execucions, una memòria cau controlada i un volum de dades del món real.
Quines consultes val la pena optimitzar primer?
Comença amb les consultes que representen la major part del temps total d'execució, no pas amb la més lenta aïlladament. Una consulta de 40 ms que s'executa 200.000 vegades al dia requereix al voltant de 8.000 segons, mentre que un informe de 30 segons executat dues vegades només en requereix 60. L'extensió pg_stat_statements us proporciona aquesta visió general.
Activa pg_stat_statements
L'extensió forma part dels mòduls contrib de PostgreSQL i s'ha de carregar quan el servidor s'inicia. En un Desplegament amb Docker, afegiu `shared_preload_libraries = 'pg_stat_statements'` al fitxer `postgresql.conf` muntat al contenidor, o passeu aquest paràmetre amb l'opció `-c` al comandament del servei. A continuació, reinicieu el contenidor i executeu `CREATE EXTENSION pg_stat_statements;` a la base de dades d'Odoo.
Tingueu en compte que el canvi requereix reiniciar PostgreSQL, per tant és aconsellable programar-lo fora de l'horari laboral. La sobrecàrrega de l'extensió és baixa i queda més que compensada per les informacions que proporciona.
Ordena per impacte real
Per veure quant contribueix cada consulta a la càrrega, ordena per `total_exec_time` en lloc de només per `mean_exec_time`:
```sql```
instruccions SELECT,
round(total_exec_time::numeric, 0) AS total_ms,
round(mean_exec_time::numeric, 1) AS average_ms,
fileres,
shared_blks_hit, shared_blks_read,
left(query, 120) AS query
DE pg_stat_statements
ORDENAR PER total_exec_time descendent
Límit de 10;
```
La relació entre `shared_blks_hit` i `shared_blks_read` indica quina part es serveix des de la memòria cau de PostgreSQL i quina requereix lectura des del disc o de la memòria cau del sistema operatiu. Una consulta amb molts blocs llegits i poques files retornades és un clar candidat per beneficiar-se d'un índex.
Com a exemple, imagina que la consulta que llança l'ORM d'Odoo en obrir la llista de factures d'un client apareix en primera posició. Té una mitjana de 180 ms i s'executa 45 000 vegades al dia, sumant un total d'uns 8 100 segons al dia – més de dues hores de temps de CPU. Aquesta és la consulta en què ens centrarem durant la resta d'aquest article.
Com genera aquestes consultes l'ORM d'Odoo?
L'ORM tradueix cada `search()`, `read_group()` o vista de llista a SQL mitjançant un patró molt reconeixible. Si el pots llegir, sabràs quin índex falta sense haver de mirar el codi Python. En el nostre exemple, `pg_stat_statements` mostra una cosa així, amb els paràmetres normalitzats:
```sql```
SELECT "account_move"."id" FROM "account_move"
ON ("account_move"."company_id" IN ($1))
I ("account_move"."move_type" IN ($2, $3))
I ("account_move"."state" = $4)
I ("account_move"."partner_id" = $5)
ORDER BY "account_move"."invoice_date" DESC, "account_move"."id" DESC
Límit 80;
```
Hi ha diverses característiques típiques. El filtre per `company_id` apareix a causa de les regles multiempresa, fins i tot si només tens una empresa. L'`ORDER BY` prové de l'`_order` del model o de la vista, i el `LIMIT 80` correspon a la paginació per defecte de la vista de llista. L'ORM llavors fa una segona consulta per recuperar els camps visibles per a aquests 80 identificadors.
Cada camp declarat amb `index=True` al model genera un índex B-tree d'una sola columna. A `account_move`, `partner_id` i `state` normalment s'indexen per separat. El planificador pot utilitzar-ne un, però amb índexs separats no gestiona gaire bé el filtratge i l'ordenació simultanis. Per això apareixen plans que llegeixen milers de registres per retornar només 80.
Abans de fer cap canvi, comproveu també si la lentitud és causada per un camp calculat amb `store=False` o per una regla d'índex complexa. Cap índex pot solucionar una regla que generi subconsultes a `res_partner` per a cada fila.
Com llegir un pla d'execució amb EXPLAIN
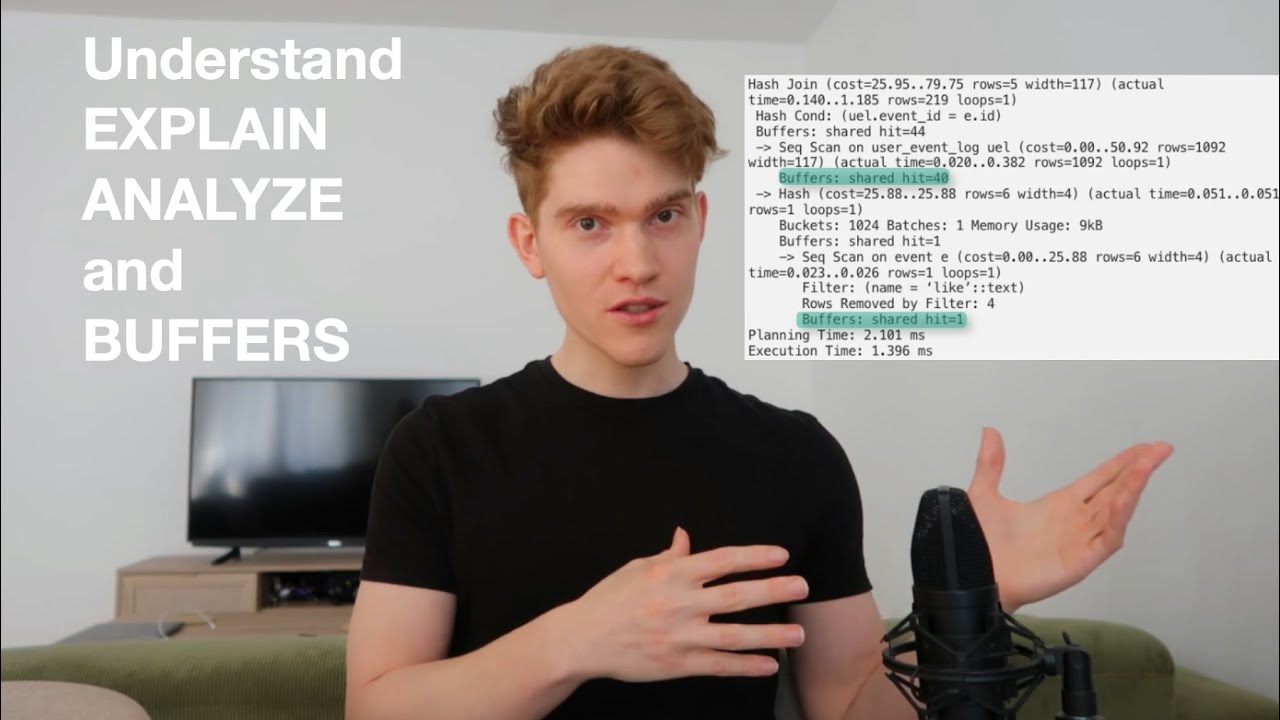

Un pla és un arbre de nodes: els fills produeixen files i els pares les consumeixen. Es llegeix de dins cap a fora. Per a cada node, es comparen les files estimades amb les reals i s'identifica on es concentra el temps i es llegeix el nombre més gran de blocs.
EXPLAIN enfront d'EXPLAIN (ANALYZE, BUFFERS)
`EXPLAIN` per si sol mostra el pla estimat sense executar res. Es basa en les estadístiques de la taula i és instantani, però només proporciona estimacions. `EXPLAIN (ANALYZE, BUFFERS)` executa realment la consulta i afegeix els temps d'execució reals, el nombre real de files per node i el nombre de blocs llegits de la memòria cau (`shared hit`) o de fora d'ella (`read`).
Recorda que ANALYZE executa la instrucció. Un EXPLAIN ANALYZE DELETE elimina registres, i un UPDATE modifica dades i activa disparadors. Per analitzar les operacions d'escriptura, inclou-les sempre dins d'una transacció d'aquesta manera:
```sql```
Comença;
EXPLAIN (ANALYZE, BUFFERS) UPDATE account_move SET . WHERE .;
Retrocedir;
```
Fins i tot amb ROLLBACK, la sentència adquireix bloquejos mentre s'executa. Per tant, quan s'analitza una sentència de producció, és aconsellable utilitzar una còpia restaurada de la còpia de seguretat més recent.
Cost, files i blocs
Un node típic té aquest aspecte:
```
Escaneig d'índex mitjançant l'`account_move_partner_id_index` a la taula `account_move`
(cost=0.43.9821.55 rows=310 width=8)
(hora actual=0.05.171.20 files=4120 bucles=1)
Filtre: (estat = 'publicat' I tipus_desplaçament = QUALSEVOL (.))
Fileres eliminades pel filtre: 2.950
Buffers: lectures compartides=1210, lectures=5340
```
El cost (`0.43.9821.55`) s'expressa en unitats arbitràries del planificador. Els dos valors indiquen els costos inicial i total en termes relatius; no són equivalents a mil·lisegons. S'utilitzen per comparar plans alternatius per a la mateixa consulta, no per predir els temps d'execució. El temps real es dóna en `temps real`.
Estigues atent a tres senyals. El primer és que s'havien estimat 310 files, però se'n van retornar 4.120 – més de 13 vegades el nombre esperat – cosa que normalment indica estadístiques inexactes. El segon és que `Rows Removed by Filter` mostra que l'índex localitza registres que posteriorment s'eliminen. El tercer és que els 5.340 blocs llegits fora de la memòria cau, de 8 kB cadascun, sumen al voltant de 42 MB d'operacions de lectura per retornar 80 identificadors.
Per sobre d'aquest node, s'executarà una operació `Sort` sobre les 4.120 files per aplicar l'`ORDER BY invoice_date DESC` abans del `LIMIT`. Aquí rau tot el coll d'ampolla: localitzar massa files, filtrar-les i ordenar-les a la memòria.
Per a consultes de llarga durada, exporta la consulta amb `FORMAT JSON` i enganxa-la a explain.dalibo.com, que dibuixa l'arbre i ressalta els nodes més costosos. Si utilitzeu PostgreSQL 18, llançat el 25 de setembre de 2025, EXPLAIN també mostra més detalls sobre les operacions d'E/S, les cerques d'índex i l'activitat WAL per node, la qual cosa accelera aquest diagnòstic.
És l'escaneig seqüencial sempre un problema?
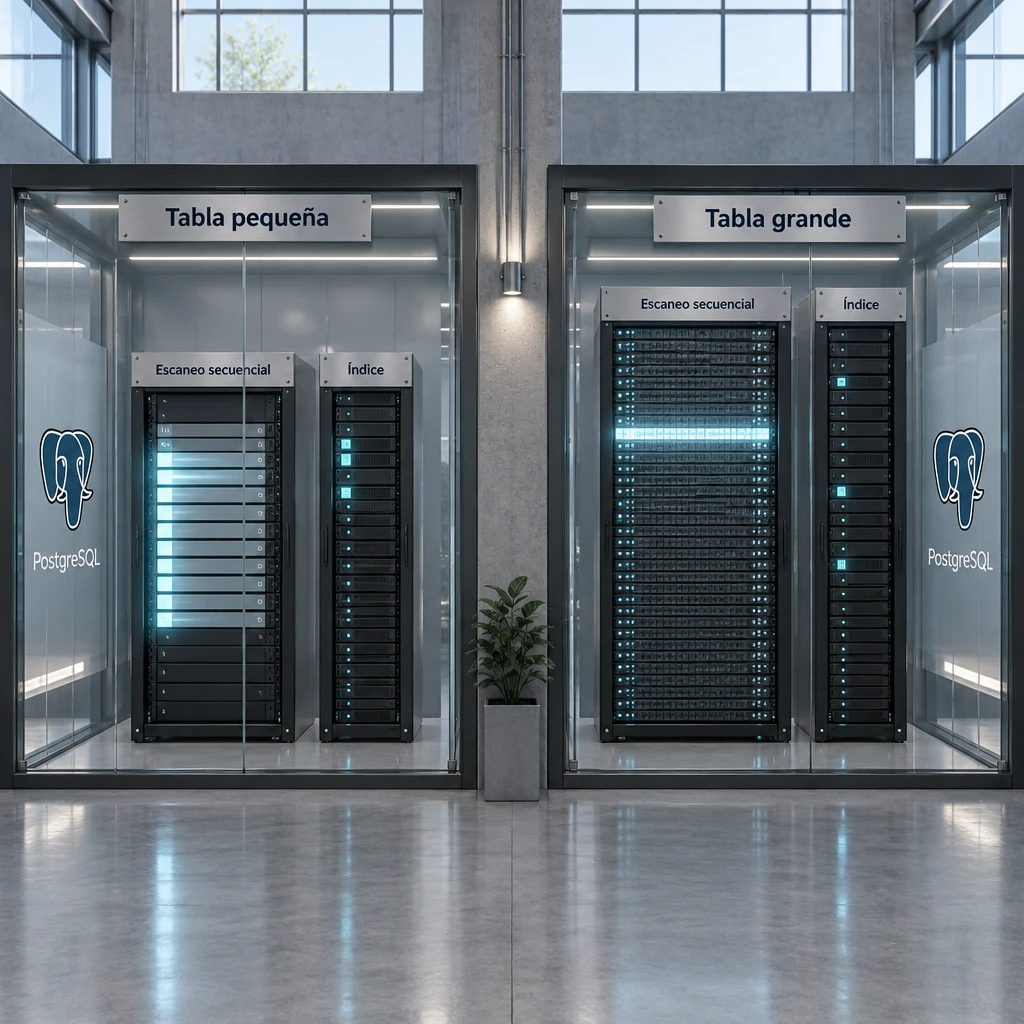
No. Una exploració seqüencial és la millor opció quan la taula és petita o la consulta requereix una gran proporció de les seves files. Llegir les pàgines en ordre és molt més eficient que saltar aleatòriament entre l'índex i la taula.
El planificador tria entre quatre estratègies principals:
- Seq Scan: escaneja tota la taula. És adequat per a taules amb uns quants milers de registres, com ara `res_company` o `account_journal`, i per a informes que agrupen gairebé totes les dades.
- Escaneig d'índex: escaneja l'índex i accedeix a la taula (el heap) per a cada fila trobada. És ideal per a un nombre reduït de files o per retornar-les en ordre ordenat.
- Bitmap Heap Scan: primer crea un mapa de les pàgines que contenen files vàlides i després les llegeix en ordre físic. És adequat per a rangs de mida intermèdia, des de centenars fins a desenes de milers de files, i pot combinar diversos índexs mitjançant `BitmapAnd`.
- Escaneig només d'índex: retorna els resultats utilitzant només l'índex, sense accedir a la taula, sempre que el mapa de visibilitat estigui actualitzat. Aquest és el mètode més eficient.
Un Seq Scan indica un problema quan es produeix a `account_move_line`, `stock_move` o `mail_message` – taules que contenen milions de registres – i només en retorna unes quantes dotzenes. En aquests casos, un valor de `Rows Removed by Filter` proper al nombre total de registres de la taula és un senyal revelador.
Tampoc no hauríeu d'obligar a l'ús d'un índex amb `SET enable_seqscan = off`, excepte com a experiment puntual dins d'una sessió. Això és útil per veure quin cost estimaria el planificador amb l'índex, però mai no s'hauria de deixar com a configuració permanent.
Per què PostgreSQL ignora un índex existent?
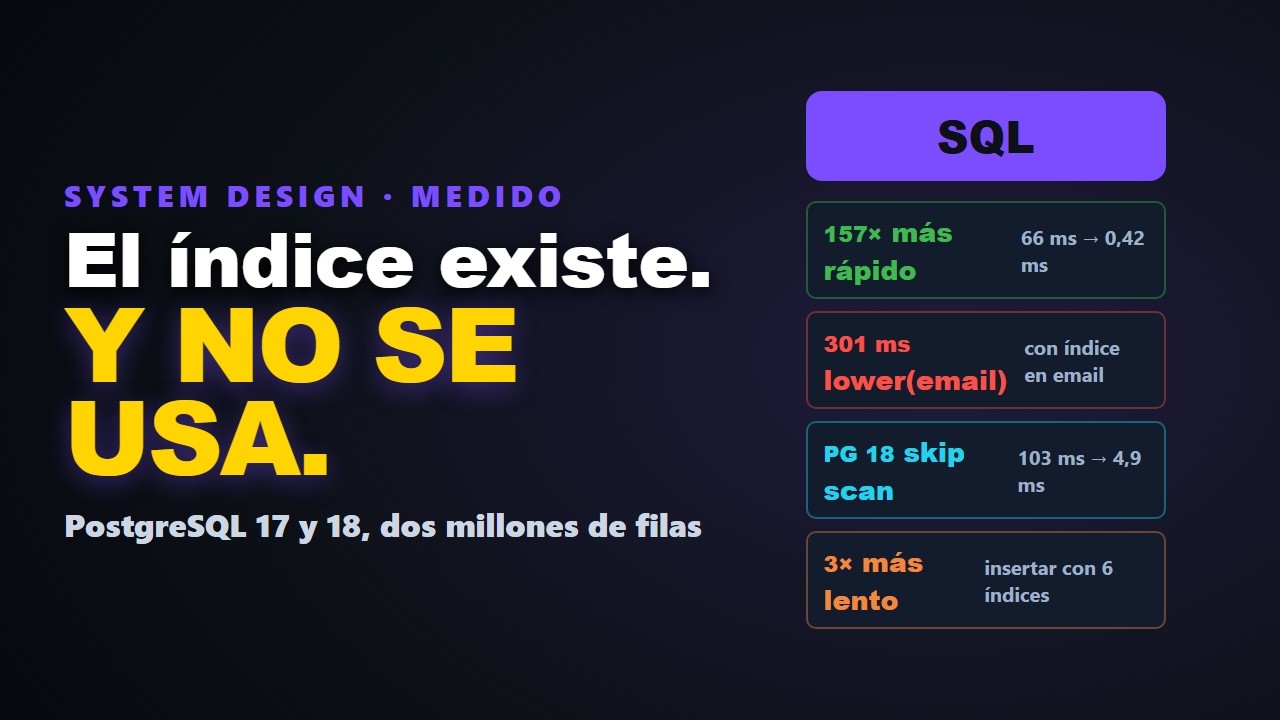
El planificador ignora un índex quan calcula que una altra ruta és més barata. Les raons habituals inclouen estadístiques obsoletes, una condició que impedeix l'ús de l'índex o una selectivitat tan baixa que resulta més rendible consultar tota la taula.
Estadístiques, ANALYZE i autovacuum
Totes les estimacions de fila es deriven de les estadístiques recollides per `ANALYZE`: els valors més freqüents, els histogrames i la proporció de valors nuls per columna. Si, després d'una importació massiva o d'una migració de dades, aquestes estadístiques encara descriuen la taula tal com era abans, el planificador prendrà una decisió incorrecta. Executa `ANALYZE account_move;` després de qualsevol càrrega de dades gran.
Autovacuum executa automàticament ANALYZE quan al voltant del 10 per cent de les files han canviat (`autovacuum_analyze_scale_factor = 0.1`) i VACUUM quan al voltant del 20 per cent han canviat. Per a taules amb 20 milions de registres, això significa esperar 2 milions de canvis. Per a taules grans d'Odoo, redueix aquests llindars per a cada taula:
```sql```
ALTER TABLE compte_moviment_línia
SET (autovacuum_analyze_scale_factor = 0.02,
autovacuum_vacuum_scale_factor = 0.05);
```
VACUUM també és important per al pla d'execució. Manté el mapa de visibilitat que permet les escanejades només d'índex i elimina els tuples morts, que inflen les taules i els índexs. Comproveu `n_dead_tup` i `last_autoanalyze` a `pg_stat_user_tables` per veure si el manteniment s'està duent a terme a temps. Si una columna té una distribució molt asimètrica, com ara `state`, amb un 95 per cent dels valors sent `posted`, augmenta la mida de la mostra amb `ALTER TABLE . ALTER COLUMN state SET STATISTICS 1000;`.
Circumstàncies que t'impedeixen aprofitar l'índex
Un índex B-tree sobre `name` no és adequat per a `WHERE lower(name) = .`, ni per a `ILIKE '%text%'`, ni quan hi ha una conversió de tipus implícita. Odoo genera moltes consultes `ILIKE` sobre els camps `name`. Per a aquestes consultes, l'índex adequat és un índex GIN amb `pg_trgm`, que Odoo crea per als camps declarats amb `index='trigram'`.
En un índex compost, l'ordre de les columnes també és important. Un índex `(company_id, partner_id)` és de poca utilitat per a una consulta que filtra només per `partner_id`. PostgreSQL 18 va introduir l'escaneig per salt de l'arbre B (B-tree skip scan), que en alguns casos utilitza els índexs sense fer servir la seva primera columna, però això només és efectiu quan aquesta columna té pocs valors diferents.
Com dissenyar un índex B-tree, compost o parcial
Per a la nostra consulta de factures, l'opció correcta és un índex compost B-tree parcial que cobreix tant les condicions d'igualtat del filtre com l'ordre de classificació dels resultats. D'aquesta manera, PostgreSQL només llegeix les primeres 80 entrades i no ordena res a la memòria.
L'ordre de les columnes en un índex compost
En primer lloc, col·loqueu les columnes filtrades per igualtat, després les que filtren per rang i, finalment, les de la clàusula `ORDER BY`, totes en la mateixa direcció. D'entre les columnes per igualtat, comenceu amb la que utilitzeu més sovint de manera aïllada en altres consultes, perquè l'índex es pot utilitzar per a qualsevol prefix de les seves columnes. La documentació de PostgreSQL il·lustra aquest concepte amb un índex `(major, minor)` per a consultes que filtren per ambdós.
Aplicat a l'exemple, `partner_id` apareix en primer lloc (es filtra per igualtat i és molt selectiu), seguit de `invoice_date DESC` i `id DESC` per a l'ordenació:
```sql```
CREATE INDEX CONCURRENTLY account_move_partner_invoice_idx
ON account_move (partner_id, invoice_date DESC, id DESC)
ON estat = 'publicat'
I move_type IN ('out_invoice', 'out_refund');
```
`company_id` s'omet perquè, amb només una empresa, no filtra res. Si estàs treballant amb diverses empreses i les dades estan realment separades per empresa, afegeix-lo immediatament després de `partner_id`.
Quan triar un índex parcial
Un índex parcial només emmagatzema les files que satisfan la seva condició `WHERE`. Això és útil quan la consulta sempre filtra pel mateix valor i aquest subconjunt representa una part ben definida de la taula. Si les entrades de borrador, les entrades de diari i les factures de proveïdor representen el 60 per cent de `account_move`, l'índex ocupa menys de la meitat de l'espai. A més, les transaccions que impliquin aquelles files excloses no el modifiquen.
El planificador només l'utilitza si la consulta implica lògicament la seva condició. Si l'ORM envia `state = $4` com a paràmetre genèric, pot no reconèixer aquesta implicació en els plans genèrics. Verifica que l'índex aparegui en el pla final i utilitza `CONCURRENTLY` per evitar bloquejos en les escriptures mentre es construeix.
El cost de registre i manteniment
Cada índex s'actualitza amb cada INSERT i DELETE, i amb cada UPDATE que afecta les seves columnes o que no es pot resoldre com una actualització HOT. A `account_move`, confirmar una factura canvia l'`state`, cosa que desencadena la inserció de l'entrada a l'índex parcial. Això també augmenta la quantitat de WAL generada, la mida de les còpies de seguretat i la càrrega de treball per al VACUUM.
Un índex compost amb tres columnes sobre 3 milions de registres pot ocupar entre 100 i 150 MB. Si l'afegiu sense eliminar res, la memòria compartida acaba repartida entre més estructures. Comproveu `pg_stat_user_indexes` i suprimiu els índexs amb `idx_scan = 0` després de diverses setmanes d'activitat normal, excepte els que garanteixen la unicitat.
Mesura abans i després sense enganyar-te a tu mateix.
Valida cada índex mitjançant una mesura reproduïble de tota la càrrega, no pas d'una sola execució. La segona execució de qualsevol consulta sol ser més ràpida perquè els blocs ja són a la memòria cau. Si no ho teniu en compte, atribuïreu a l'índex una millora que no es mereix.
Seguiu aquests passos:
- Restabliu una còpia de seguretat recent de producció en un entorn equivalent, amb el mateix volum de dades i la mateixa versió de PostgreSQL, i executeu `ANALYZE`.
- Executa la consulta cinc a deu vegades amb `EXPLAIN (ANALYZE, BUFFERS)`, utilitzant paràmetres reals: un client amb 20 factures i un altre amb 30.000. Anota la mediana i el nombre de blocs llegits, no el millor temps.
- També mesura les operacions d'escriptura afectades – per exemple, utilitzant `pgbench` i un script que insereix i confirma factures – i registra les transaccions per segon i el WAL generat.
- Crea l'índex, repeteix els passos 2 i 3 en les mateixes condicions i compara els resultats.
- En producció, executa `SELECT pg_stat_statements_reset();` després de desplegar l'índex i, al cap d'una setmana, compara el `total_exec_time` de les consultes principals amb el de la setmana anterior.
En l'exemple, el nou pla hauria de mostrar un escaneig d'índex que s'atura en arribar a 80 registres, sense cap node de classificació i amb unes quantes desenes de blocs llegits, en comparació amb la xifra anterior de més de 6.500. Si el temps mitjà cau de 180 ms a uns 2 ms, el temps total per a les 45.000 trucades diàries baixa d'uns 8.100 segons a 90.
Aquests estalvis es comparen amb les mesures del pas 3. Si la confirmació de la factura resulta en una disminució del 2 per cent en el rendiment, el resultat global és clarament positiu. Si una importació nocturna de 500.000 línies triga una hora més, potser val la pena desactivar el procés i reconstruir l'índex després. La decisió es pren tenint en compte la càrrega de treball global de l'empresa.
Per on començar
Activa `pg_stat_statements` aquesta setmana i deixa que reculli set dies d'activitat normal. Aquesta llista, ordenada pel temps total, et permetrà identificar les tres o quatre consultes que val la pena optimitzar i ignorar la resta sense crear índexs a l'atzar. Si preferissis disposar de suport tècnic per al teu Instal·lació d'Odoo a Barcelona, Synergia ofereix això amb un SLA de resposta de dues hores.
Preguntes freqüents
Quants índexos pot tenir una taula sense afectar el rendiment?
No hi ha un nombre fix. El límit el determina la relació entre lectures i escriptures. En taules amb un alt volum d'escriptures, com ara `account_move_line` o `stock_move`, cada índex addicional té un impacte notable en els temps de commit, així que cal justificar-ne cadascun executant una consulta específica a `pg_stat_statements`.
És possible crear un índex en producció sense aturar Odoo?
Sí, utilitzant `CREATE INDEX CONCURRENTLY`, que no bloqueja les escriptures. Triga més i no es pot executar dins d'una transacció. Si falla, deixa un índex marcat com a invàlid, que has d'eliminar abans de tornar-ho a provar.
Amb quina freqüència s'ha d'executar ANALYZE manualment?
Autovacuum sol ser suficient, configurat per a cada taula en el cas de taules més grans. Executa `ANALYZE` manualment després d'importacions massives, migracions o supressions a gran escala, ja que, si no, l'optimitzador treballaria amb estadístiques que descriuen una taula diferent.
Augmentar `work_mem` ajuda a accelerar les consultes?
Això és útil quan el pla mostra operacions de classificació o d'hash que superen la capacitat de memòria i que s'externalitzen al disc (`Mètode de classificació: fusió externa`). Utilitzeu aquesta funció amb precaució: s'assigna per operació i per connexió, i amb molts processos de negoci d'Odoo en funcionament, pot esgotar la memòria del servidor.